当模型能力越来越像公共基础设施,真正拉开差距的,可能就不是谁先接上模型,而是谁先把上下文、约束和工作流组织起来。
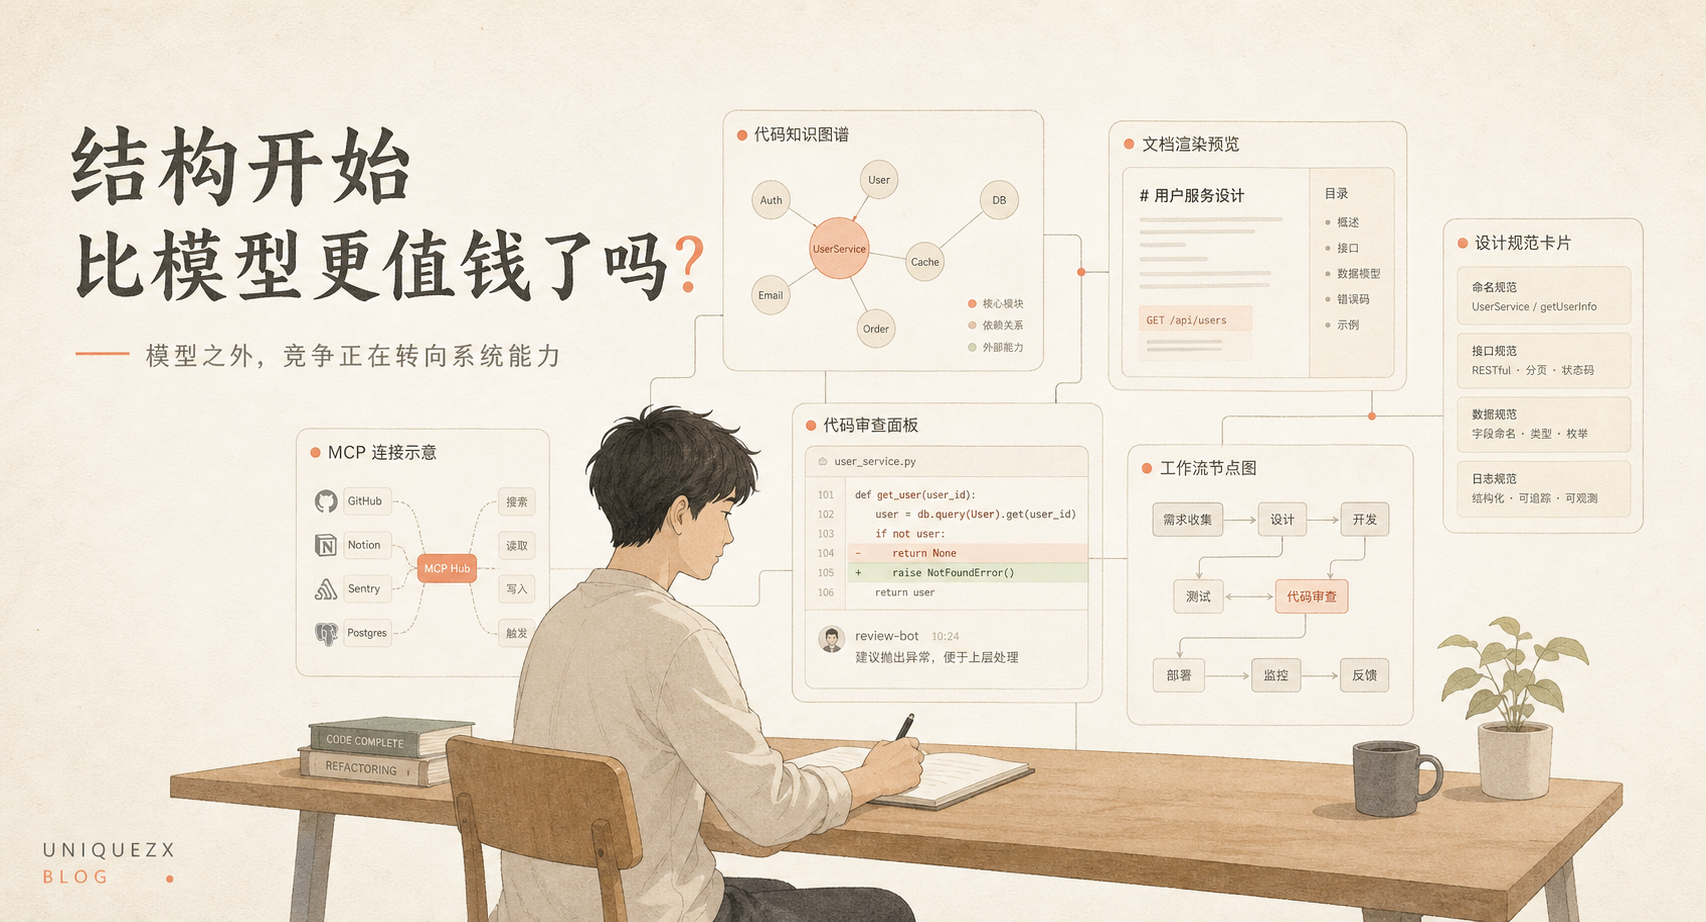
触发:这周我越来越强烈地感觉到,AI 编程开始往“结构层”走了
这周我看了一些热门仓库,也顺手关注了过去一周几个和 AI Coding、Agent、工作流有关的动态。看完以后,我有一个感觉越来越强:
AI 编程的竞争,开始慢慢从“模型能力”转向“结构能力”了。
前一阶段大家最关心的是:
模型够不够强
上下文够不够长
生成够不够快
多模态够不够全
但这周真正让我觉得有意思的东西,反而都不在模型本身上,而是在补那些过去最容易被忽略的结构层空白:
代码库结构怎么长期理解
Word、Excel、PPT 这类文档怎么真正被 AI 看见
AI 生成的页面怎么减少模板味和“AI 味”
代码质量、Code Review、提示词怎么逐步工程化
我先把这周最值得看的 3 个仓库原样放在这里,后面再说我真正沉淀下来的判断。
热门仓库
https://github.com/tirth8205/code-review-graph

它通过分析代码结构,将项目转换成一张代码知识图谱(Code Knowledge Graph)。
主要原理是 Tree-sitter 解析源码,提取文件、类、函数、调用关系、依赖关系等信息变成结构化数据存储到数据库中,并通过 MCP 暴露给 Codex、Claude Code 等 AI Agent 使用。
相比传统 AI Coding 直接读取大量代码文件,Code Review Graph 可以让 AI 先理解项目结构,再精准获取相关上下文,从而降低 Token 消耗,提高代码分析和 Review 的准确性。
这让我看到未来 AI 编程工具的一个方向:AI 不只是阅读代码,而是拥有对代码库结构和关系的长期理解。学习一下吧,不知道是否真的有用,我觉得codex,Claude code目前的代码查找能力也挺厉害的了。不知道有没有人对比过。后面研究研究看看如何使用
https://github.com/iOfficeAI/OfficeCLI/tree/main
让任何 AI 智能体完全掌控 Word、Excel 和 PowerPoint——只需一行代码。
开源免费。单一可执行文件。无需安装 Office。零依赖。全平台运行。
OfficeCLI 的内置 HTML 渲染引擎,高度还原文档原貌 —— 这正是让 AI 拥有"眼睛"的关键。 它把 .docx / .xlsx / .pptx 渲染为 HTML 或 PNG,闭合"渲染 → 看 → 改"的循环。
https://github.com/Nutlope/hallmark
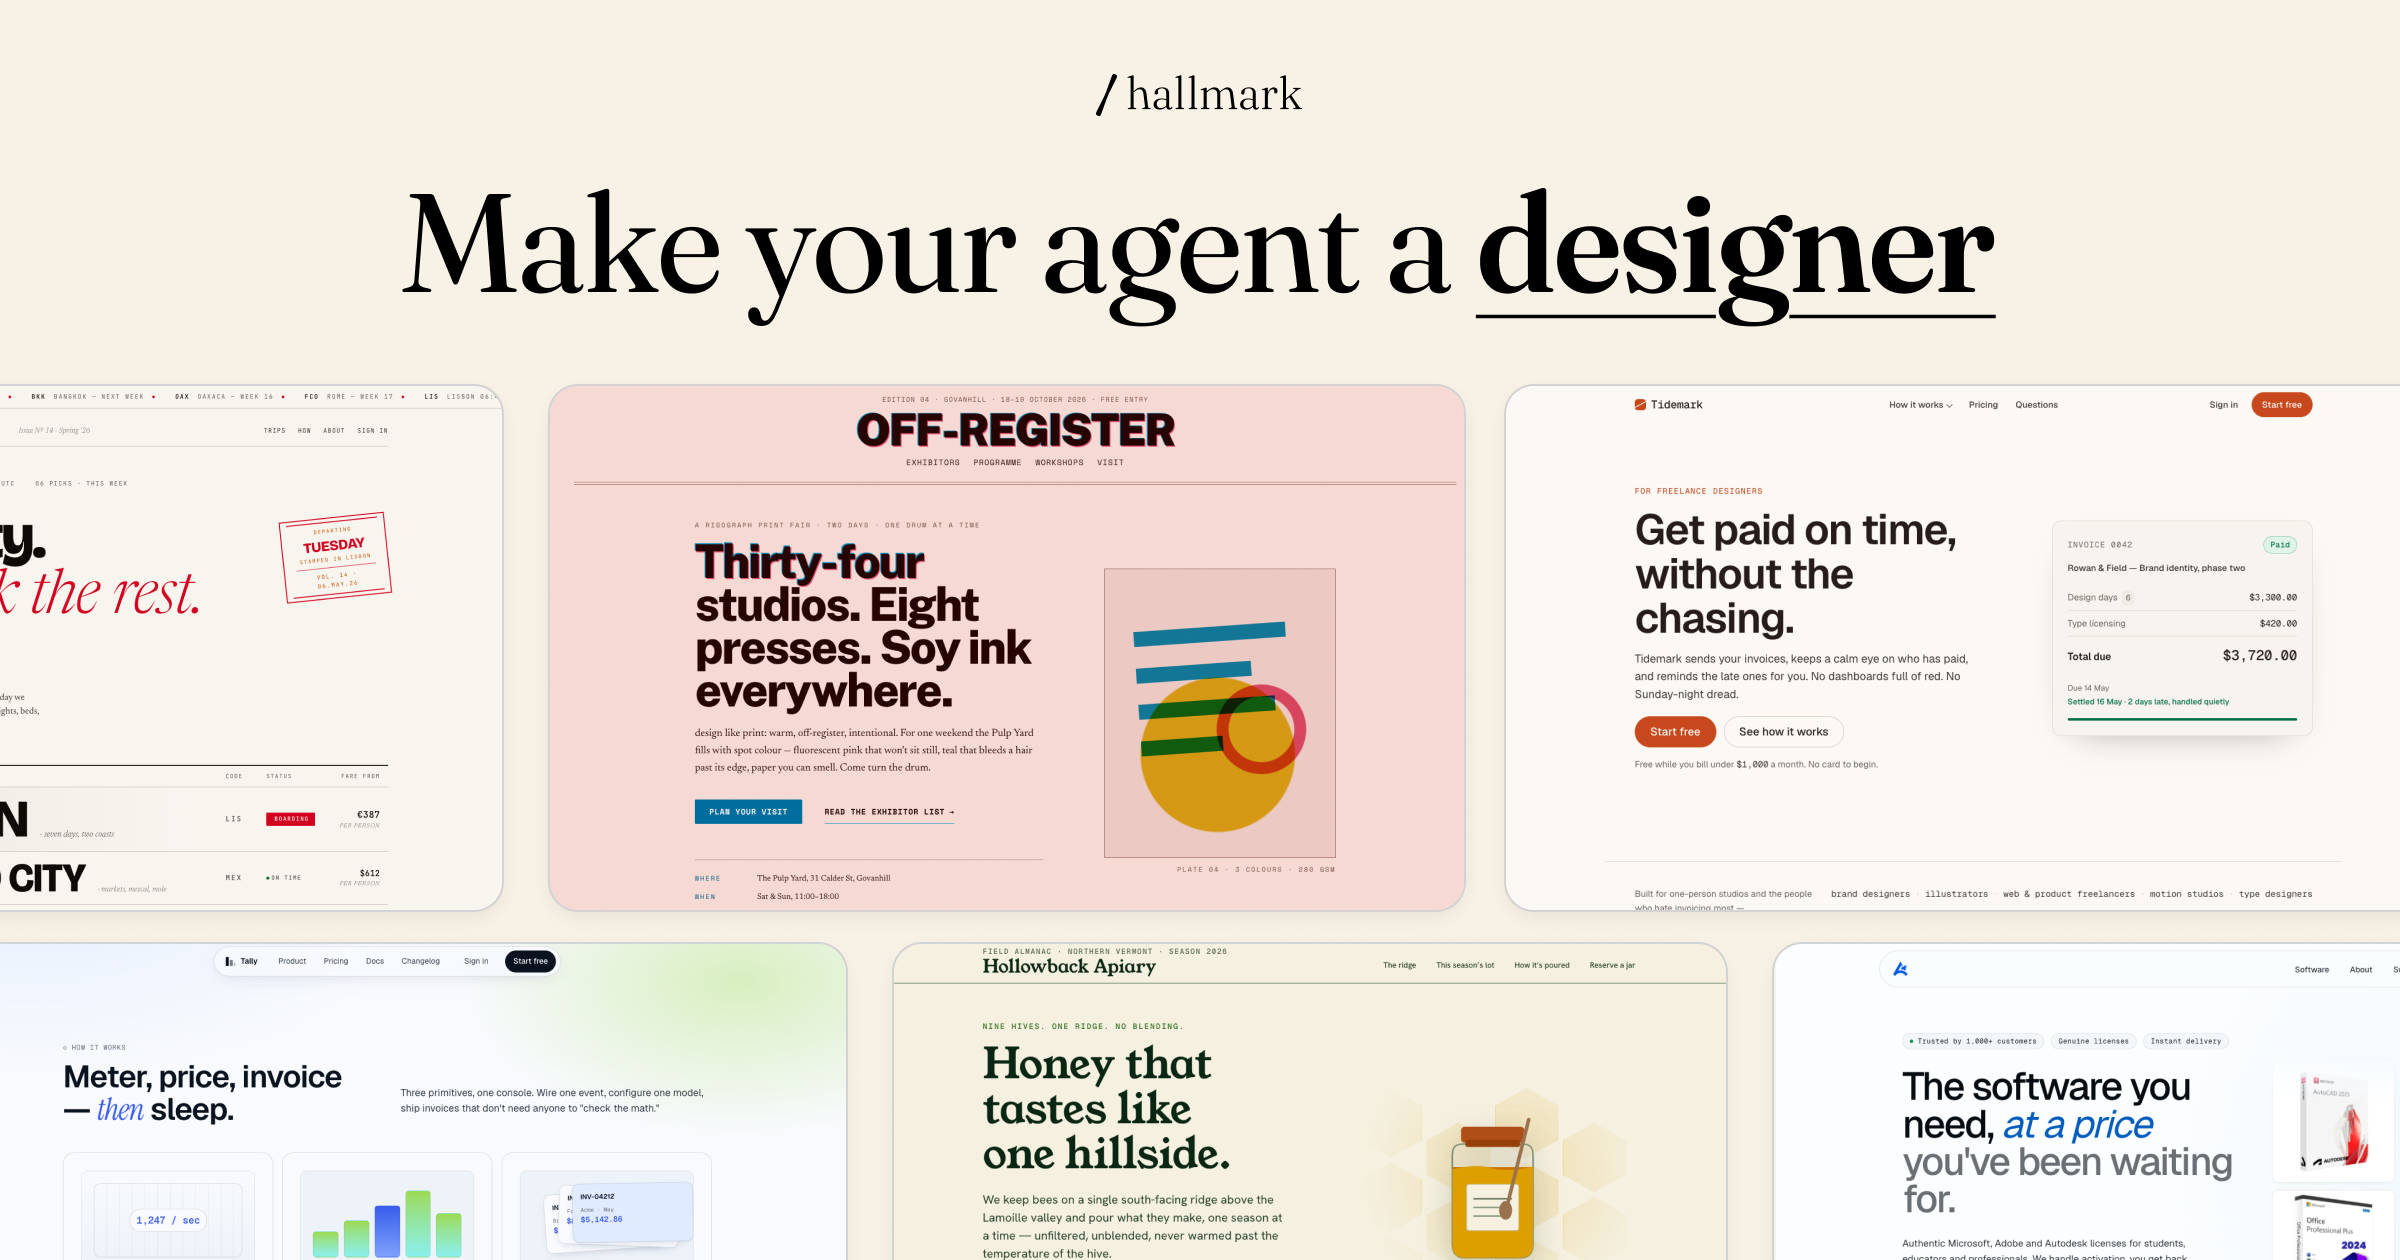
设计技能包,用来让 AI 生成的页面更不像模板味、更不像“AI 味”。
观察:这三个仓库指向的是同一件事
单看这 3 个仓库,它们分属不同方向:
code-review-graph在补代码上下文结构OfficeCLI在补办公文档的视觉闭环hallmark在补 AI 生成结果的风格控制
但如果放在一起看,它们其实都在做同一件事:
不是让模型更强,而是让模型更像一个能进入真实工作流的系统。
我觉得这很关键。因为现在单纯“接一个模型接口,然后生成点什么”的门槛已经越来越低了。接下来真正值钱的,很可能不是“谁会调模型”,而是:
谁能把正确的上下文送进去
谁能把结果约束在可用范围内
谁能让 AI 输出进入真实交付流程
所以如果用一句更像我自己会说的话总结,就是:
模型能力开始慢慢公共化以后,真正难的不是生成,而是组织。
对比:我不完全同意“AI Application 很危险”,但我同意“薄应用会越来越危险”
我这周写 WAIC 观察的时候,有个判断我自己觉得方向对,但说法还可以更准确一点。
我原来写得比较直,差不多是:AI Application 很危险。
我现在更愿意把它改成:
不是 AI Application 整体危险,而是“只有一层很薄的模型套壳应用”越来越危险。
这两者差别其实很大。
因为如果一个产品只是把大模型能力换个界面、换个入口、换个包装卖出去,那它确实很容易被下一次模型升级、平台内置、系统级集成直接吞掉。比如以前很多“帮你总结 PDF”的工具,一旦底层模型自己能直接看 PDF,它们的独立价值就会快速下降。
但应用层真正长期有机会的地方,不是这层最薄的壳,而是这些位置:
工作流入口
低摩擦体验
行业场景理解
结果质量控制
和真实数据、真实反馈绑定的闭环
所以这件事不能简单说成“应用层危险,所以别做应用”。我现在更接近的判断是:
没有工作流位置、没有结构价值、没有数据闭环的应用,会越来越危险。
机制:我这周有两个判断,需要我自己说得更严谨一点
1. Scaling Law 不能简单理解成“钱、卡、数据够了,迟早都能追上”
我原来这个说法不算完全错,但还是太粗了。
更准确一点的理解应该是:
Scaling Law 说明的是,当模型规模、数据规模和训练算力上升时,性能通常会按相对可预测的方式提升。
但它不等于:
谁砸钱谁就一定能追上
架构差异已经不重要了
后训练、推理优化、数据质量、工程效率、产品分发都不重要了
所以它更像一个趋势规律,不是一个“只要堆资源就自动成功”的万能公式。
2. 未来真正值钱的,不是“数据”这个词本身,而是高质量、可持续更新、与场景绑定的数据
我现在也不太想直接说“未来真正值钱的是数据”,因为这个说法太容易被讲空。
更准确一点应该是:
通用公开数据的边际价值在下降,但高质量、稀缺、可持续更新、和工作流强绑定的数据,会越来越值钱。
比如:
医生的诊疗经验和标注数据
律师的案件推理链和文书结构
金融从业者的决策样本和反馈闭环
企业内部长期积累的流程、文档、审查规则、用户行为数据
不是所有数据都值钱,而是那些别人拿不到、拿到也不容易用、并且能持续反馈到结果里去的数据会更值钱。
上周动态:从我的角度看,这几条比大多数“新品发布”更值得注意
1. GitHub 在 2026 年 7 月 20 日发布 Code Quality GA
这个信号我觉得很重要,因为它说明代码质量控制开始从团队内部习惯,逐步变成平台能力。
这件事的意义不只是“多了一个功能”,而是:
当 AI 让代码产出速度继续提高时,质量治理一定会越来越产品化。
过去靠高级工程师盯、靠团队自觉做的事情,后面会越来越多地下沉为平台层和系统层能力。
参考: GitHub Changelog About code quality
2. GitHub 在 2026 年 7 月 24 日把 Claude Opus 5 接进了 Copilot
这个点从我的角度看,表面像“又多了一个模型选项”,但从平台角度看,它其实是在说明:
未来开发者真正使用 AI 的入口,未必是直接找模型厂商,而更可能是通过工作平台。
也就是说,模型正在慢慢变成平台内部的一个可替换组件,而不是用户必须单独理解和管理的对象。
如果这个趋势继续下去,开发者以后更关心的可能不再是“哪个模型最强”,而是“哪个平台把模型组织得最顺手、最接近我的工作流”。
参考: Claude Opus 5 is now available in GitHub Copilot
3. GitHub 在 2026 年 7 月 23 日更新了 MCP Server 对新版规范的支持
这个信号在我看来也很值得看。因为它说明 MCP 这件事,正在慢慢从“极客玩法”往更正式的工程基础设施走。
尤其是它开始强调对新版规范、无状态连接模型等能力的支持,这意味着:
MCP 不只是 Agent 的玩具接口,而是在朝真正可扩展、可部署、可进入生产环境的方向走。
这和你关心的 AI Coding、工具链、Agent 工作流都直接相关。
参考: GitHub MCP Server supports the next MCP specification
4. WAIC 2026 结束后,我更确信“应用层不能只靠热闹”
上周 WAIC 2026 结束以后,我最大的感受不是“AI 到处都是”,而是:
共识越来越拥挤,真正的好机会反而更需要冷着看。
热闹当然是真的,基础设施赚钱也是真的,但最值得提防的,是一堆人看到热度以后,会自动把“应用层很热”误读成“随便做个 AI 应用就能成立”。
我现在反而更倾向于把 WAIC 当成一个提醒:
别被现场热度带跑,还是得回到最基本的问题:
这个东西到底解决谁的问题?
它是不是只是演示能力,不是交付结果?
如果底层模型再进化一轮,它的位置还在不在?
参考: WAIC 2026 officially opens in Shanghai WAIC 2026 closes in Shanghai
判断:我这周真正沉淀下来的观点,其实只有一句
如果把这期周刊压缩成一句话,我现在更倾向于这个判断:
模型会越来越像公共基础设施,而结构、约束、上下文和工作流位置会变得越来越值钱。
这也是为什么这周我最感兴趣的,不是某个模型又刷了什么榜单,而是这些看起来没那么“性感”的方向:
代码知识图谱
文档渲染闭环
设计反模板化
代码质量治理
MCP 规范化
平台级 AI 入口
因为这些东西更像系统能力,而不是一次性的模型表演。
开放问题
接下来我会继续观察几个问题:
code-review-graph这类结构层工具,是真的能大幅提升 Agent 效率,还是目前还只是一个很好的方向样本?Office 文档、设计系统、代码仓库这三类复杂工件,谁会最先形成稳定的 AI 工作流标准?
当平台开始把多个模型都接进去以后,独立开发者真正还能守住的位置,会不会更集中在垂直场景、工作流入口和反馈闭环?
AI Application 的下一轮机会,到底是更强的模型封装,还是更深的流程嵌入?
我现在没有最终答案。
但至少这周有一点我越来越确定:
真正值得继续追的,不是“AI 还能生成什么”,而是“AI 能不能被组织成一个真正有生产力的系统”。
评论