如果只看目录,《黑客与画家》第七、八、九章其实挺跳的。
一章在谈贫富分化,一章在讲垃圾邮件过滤,一章在讲设计者的品味。表面上看,它们几乎不像在讨论同一件事。
但我这次连着读下来,反而觉得它们都在回答同一个问题:
它们其实都在回答同一个问题,为什么有些人创造的价值会越来越大,而另一些人只能停留在表面忙碌里。
第七章拆的是财富从哪来,为什么技术进步会让人与人的生产效率差距变大。第八章表面上在讲垃圾邮件过滤,真正有意思的却是,人应该怎么用样本修正自己的直觉。第九章则更直接,它在问:如果大家都能学会技术,最后拉开作品层次的,到底是什么?
所以这三章放在一起看,反而比单独看更完整。
因为它们最后都落回同一个结论:
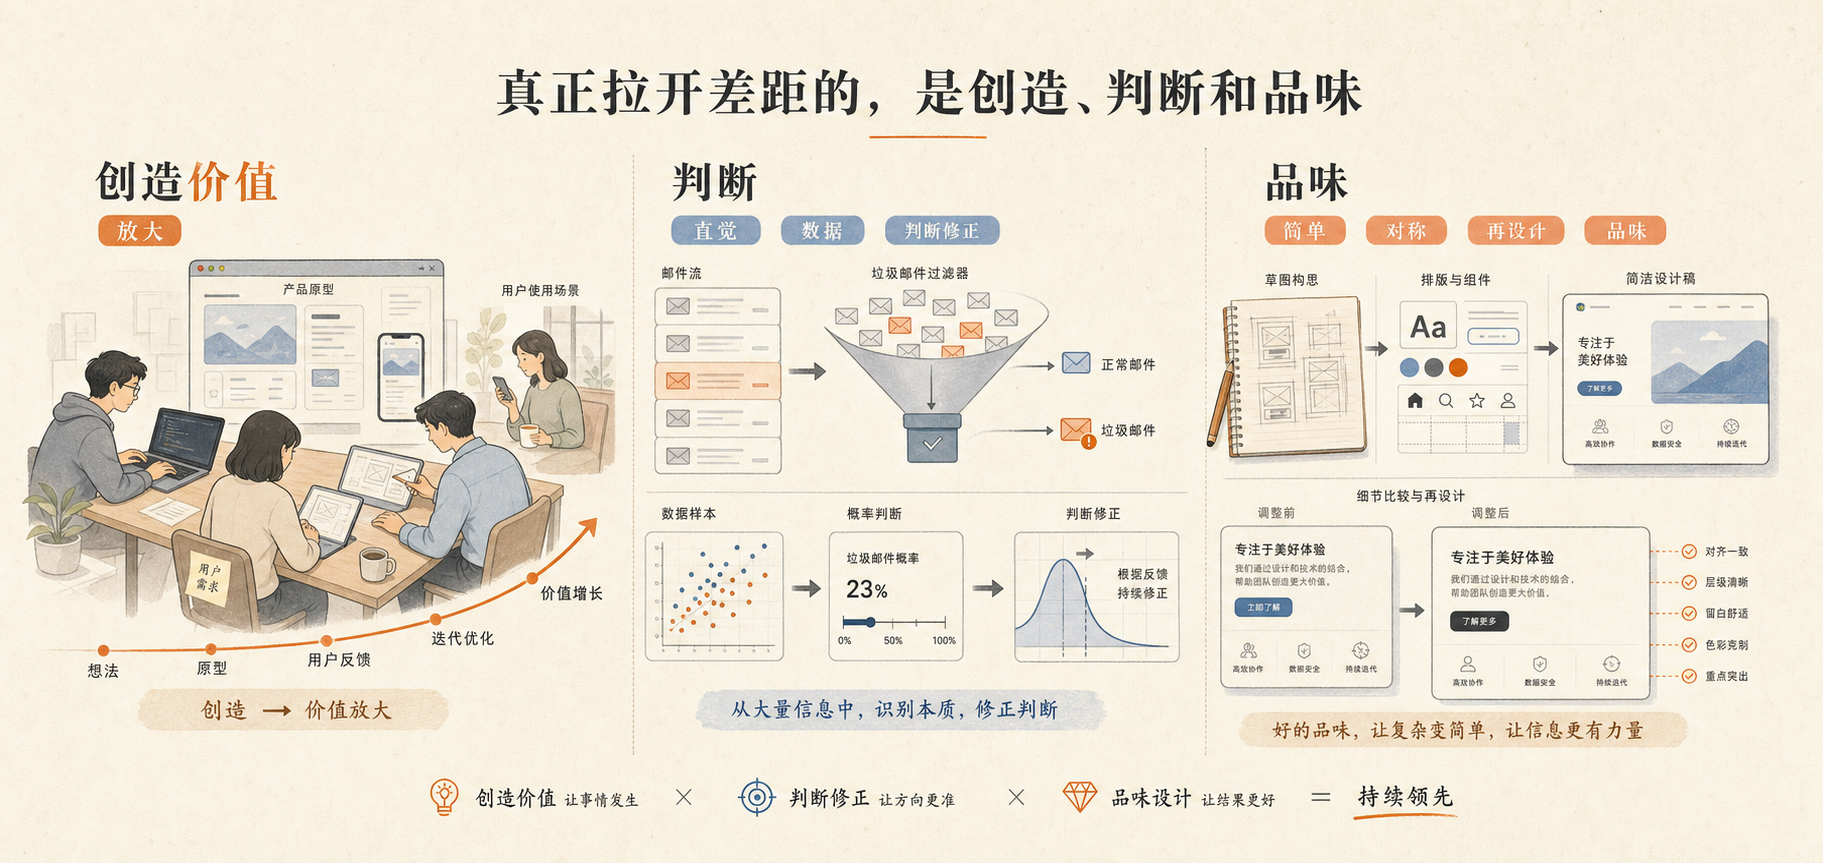
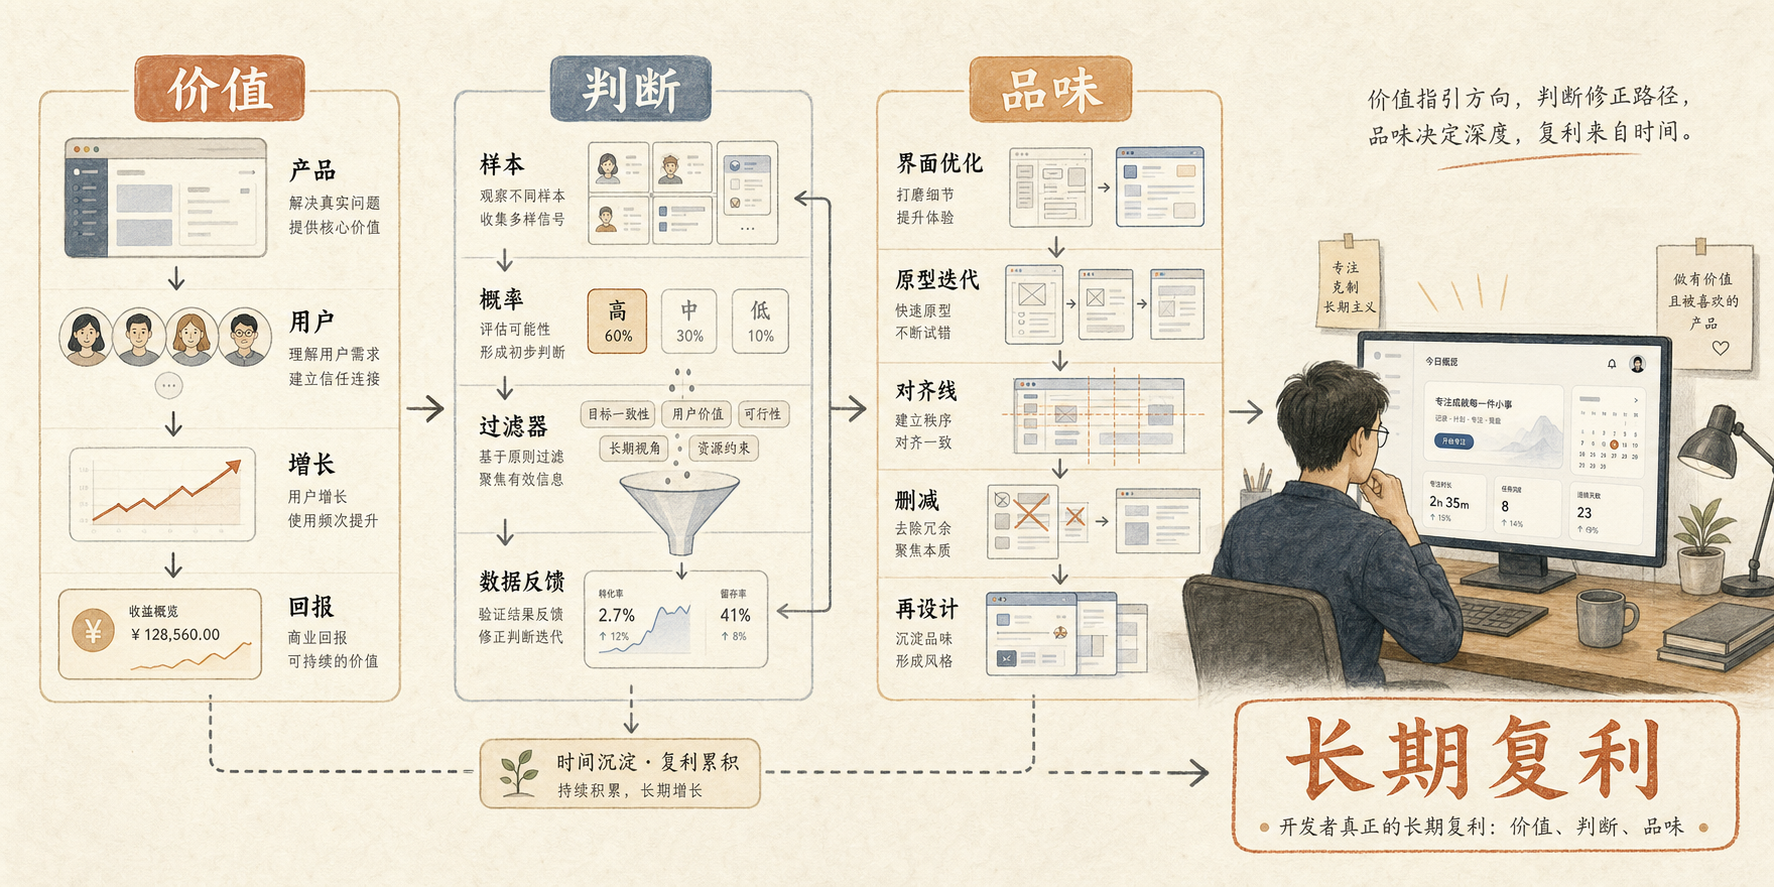
真正拉开差距的,不只是工具,而是你有没有创造价值的能力、修正直觉的判断力,以及把东西做好的品味。
一、贫富差距不是先要讨论“公平”,而是先要弄清“财富从哪来”
第七章《关注贫富分化》其实很容易让人情绪先走在前面。
因为“贫富差距”这个话题天然就带立场,也天然会触发很多人对公平、不公平的反应。但 Paul Graham 这章最有价值的地方,就是他先把一个更基础的问题拎了出来:
财富到底是什么?
他说,很多人从小对财富的理解其实就是错的。
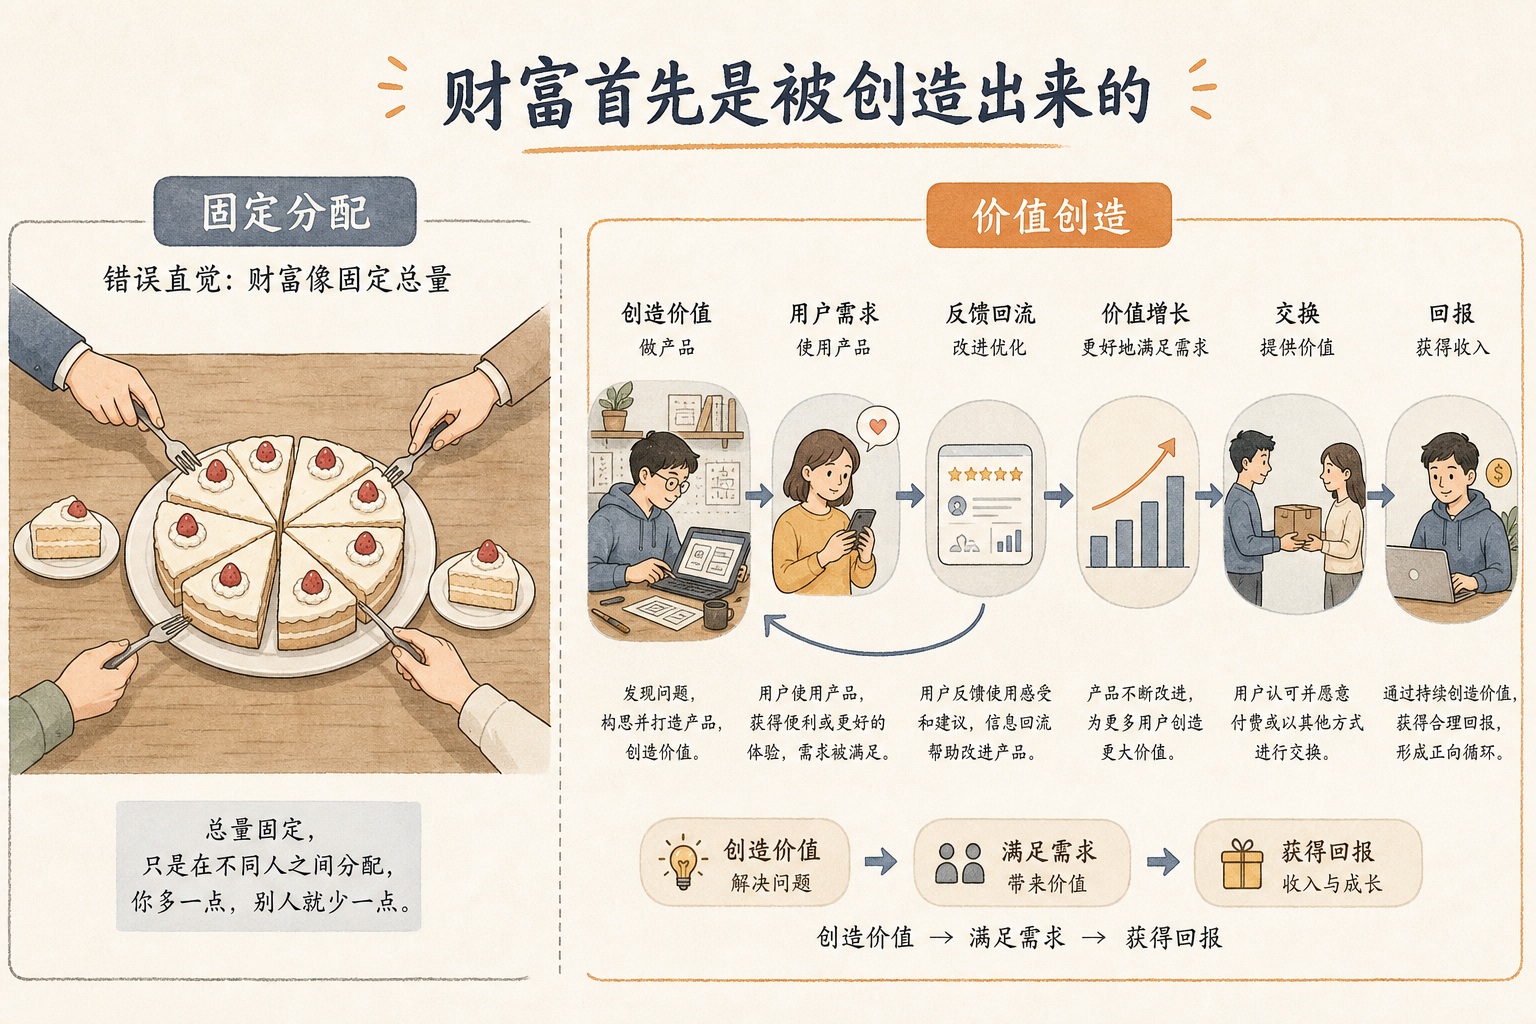
我们小时候接触钱的方式,很容易让人误以为财富像某种固定总量的东西,好像有一个大人站在上面分配,谁多一点、谁少一点,于是当有人明显比别人拿得多,就很容易下意识得出“不公平”的结论。
但问题是,财富并不是那种预先摆在桌上的东西。
钱只是交换财富的中介,真正有价值的,是商品、服务、效率、便利、工具、系统,是那些能被人使用、能满足真实需求的东西。
也就是说,财富首先不是分出来的,而是被创造出来的。
这句话我以前觉得像常识,后来越做项目越觉得,不是每个人都真的按这个逻辑在思考。
在现实工作里,很多人讨论收入、资源、机会、公司大小、行业冷热,第一反应还是“谁分到了什么”,而不是“谁到底创造了多少真实价值”。
但如果把这个问题切回开发者日常,就会变得非常具体。
一个人写了一套真的帮团队省下很多时间的工具,一个人把一个原本很难用的流程变得非常顺滑,一个人把用户愿意持续打开的产品做出来,这些都在创造财富。哪怕它们一开始看起来没有“金融”“投资”“生意”这些词那么直接,它们本质上也仍然是在创造财富。
所以我现在越来越认同一个判断:
讨论收入差距之前,先要看价值是不是被创造出来了。
如果一份收入背后真的有更高密度的价值创造,那它不一定平均,但很难说它天然不合理。
二、技术为什么会拉大差距,因为它本来就是用来放大效率的
第七章里还有一个我很认同的判断,技术会加大人与人之间的生产效率差异,这不是副作用,而是它原本就要做的事。
这句话放在今天尤其明显。
AI 时代更是这样。
一个会用工具、会写代码、会搭系统、会理解用户的人,和一个只会重复固定动作的人,效率差距可能比过去更大。不是因为后者突然变笨了,而是因为技术正在把前者的能力放大得更明显。
所以技术进步一定会让收入差距扩大吗?
Paul Graham 的回答其实比一般争论更细。他不是简单说“扩大了就是对的”,而是在区分不同种类的差距。
收入差距可能会变大,但很多其他差距反而会缩小。
比如一百年前,富人和普通人的生活方式真的是两个世界。住的房子、穿的衣服、出行方式、获取信息的能力、受教育的机会,几乎处处都有巨大的物理鸿沟。
而今天,技术一边在加大某些高技能人群的收入上限,一边也在让很多原本只有少数人才能享受的东西变得更普及。
智能手机、互联网、在线教育、地图、相机、支付系统、云服务、AI 工具,这些东西本来都可以是非常昂贵的能力,但技术把它们越来越多地推向了普通人。
这也是为什么我现在不太喜欢把“技术导致差距扩大”当成一个偷懒结论。
更准确一点应该是:
技术会放大高能力者的产出差异
但技术也会降低很多基础能力的获取门槛
所以真正要看的不是“差距有没有变化”,而是差距变化背后,价值是不是在被更多地创造,以及这些价值有没有继续向更多人扩散。
这也是 AI 时代最值得继续观察的地方。
如果 AI 最后只是让少数人更快积累资源,那它会带来新的分层。如果 AI 同时也把更多生产能力开放给普通人,那它又会缩小另一类差距。
这两件事很可能会同时发生。
三、很多人之所以讨厌差距,是因为他们很少真正接触“创造财富”这件事
第七章里有一段很尖锐,但我觉得挺有意思。
Paul Graham 说,最反对收入差距的一群人里面,有很多人其实很少直接经历“创造财富”这件事本身。比如大学生、继承人、教授、政客、记者。不是说这些职业没有价值,而是他们中的很多人,对“钱到底怎么来的”没有那么直接的体感。
这句话放到今天,当然还是要谨慎一点说,不然会变成立场攻击。
但它里面有一个我觉得很有启发的部分:
如果你长期离真实交换、用户需求和市场反馈太远,你就更容易把收入理解成一种抽象分配,而不是价值交换的结果。
这点我在技术行业里也经常能感觉到。
有些人特别容易从宏大结构、平台不公、资源倾斜这些角度解释一切,这些角度当然有它成立的时候,但如果一个人完全没有过“把东西做出来,再看用户是否愿意用、是否愿意继续留、是否愿意付钱”的经验,那他对价值的理解很容易悬空。
这也是为什么我越来越觉得,开发者最好还是要尽量接近真实用户和真实反馈。
因为一旦你真的做过产品、处理过用户、扛过增长压力、面对过没人买单的现实,你就会对“价值”这两个字有完全不同的理解。
你会知道:
不是所有努力都会自动变成价值
不是所有技术实现都能换来真实回报
用户愿意留下来,是非常具体的事情
也正因为这样,你对“财富”“收入”“差距”这些话题的判断,也会比纯站在抽象道德立场上更扎实一点。
四、垃圾邮件这一章,表面上在讲过滤器,实际上在讲怎么修正直觉
第八章《防止垃圾邮件的方法》乍看很技术。
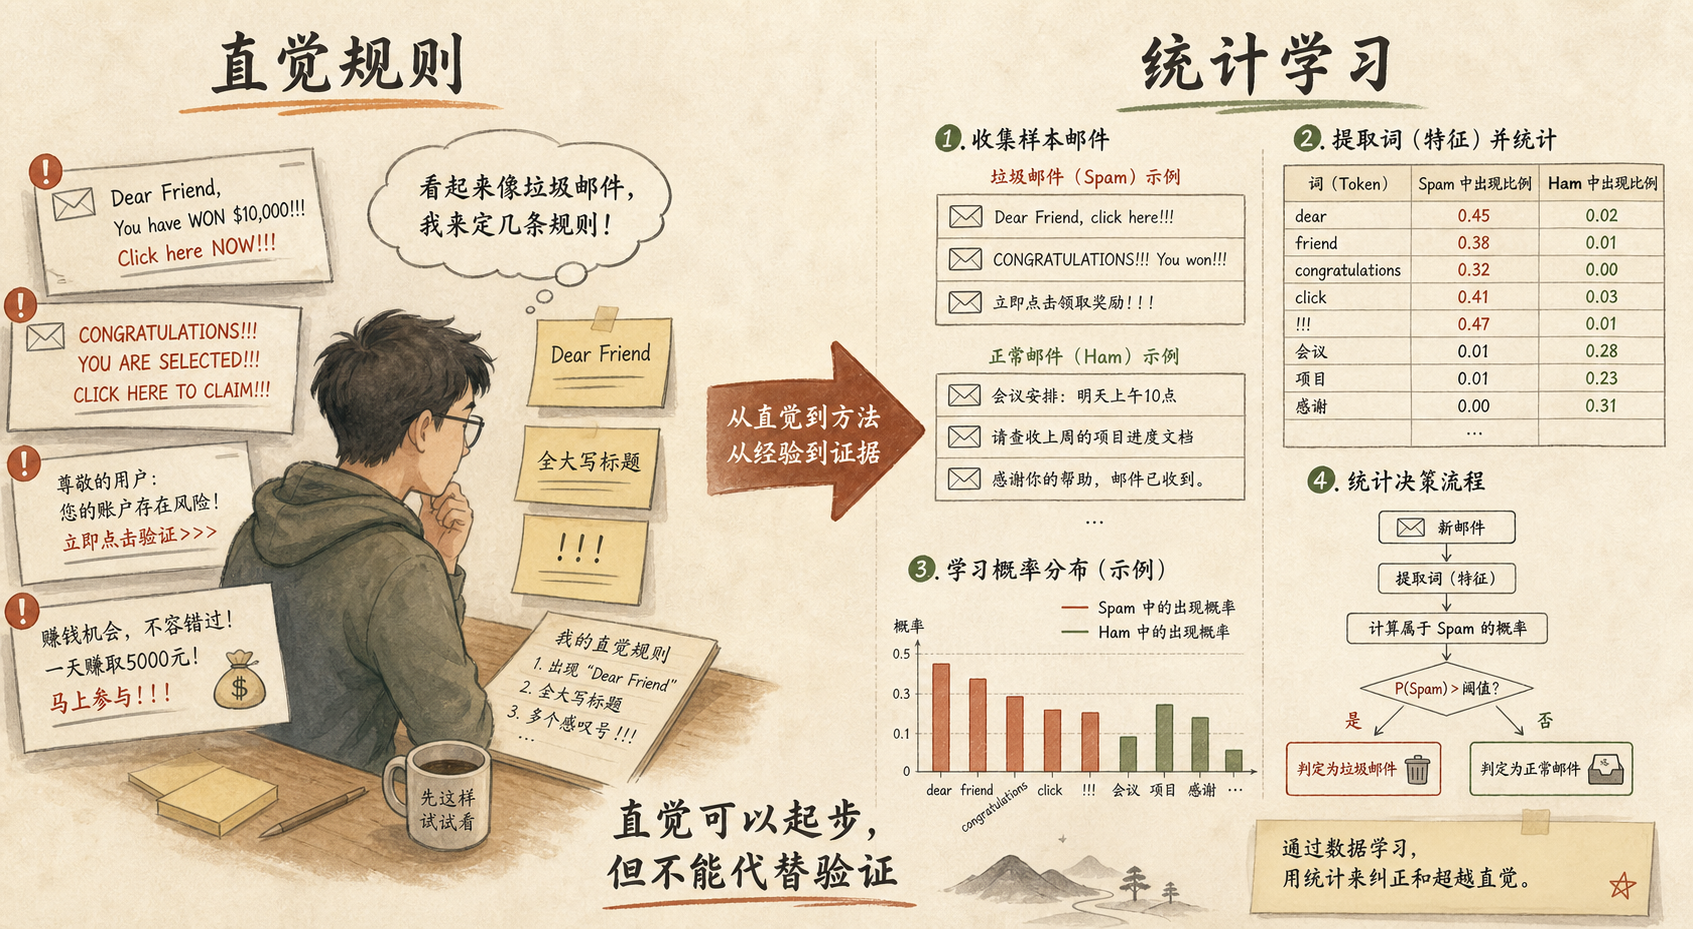
它讲的是 Paul Graham 当年怎么做垃圾邮件过滤器,怎么从一堆垃圾邮件和正常邮件样本里提取 token,怎么做统计,怎么让过滤器不只是依赖几个显眼规则,而是真正从概率层面判断一封邮件是不是垃圾邮件。
但这章让我最有感触的,其实不是技术细节本身,而是它背后那种思维方式的变化。
他说,一开始大多数黑客直觉上都会想:我来写几条规则就好了。
比如看见“Dear Friend”,看见全大写标题,看见八个感叹号,看见某些夸张促销词,就直接写一行代码把它拦掉。
这种方式一开始当然有效。
因为垃圾邮件确实会有很多肉眼很容易发现的特征。但问题是,越往后走,越难的部分就不是抓住那些明显特征,而是怎么在复杂变化里继续保持准确率,而且尽量别误杀正常邮件。
这时候,单靠人的直觉就开始不够了。
于是他用了统计学方法,结果立刻发现,机器从数据里学出来的东西,比自己的直觉聪明得多。除了那些显眼的垃圾邮件词,它还会发现一些你根本不会主动想到的信号,比如某些 HTML 颜色代码、看起来很中性的字符组合、特定格式痕迹。
这件事我觉得特别像今天我们做很多产品和工程判断时会遇到的问题。
很多时候,人不是不聪明,而是太容易迷信自己的第一反应。
我们会想当然地觉得:
用户一定是卡在这里
性能瓶颈肯定在这段代码
转化率低肯定是按钮文案不对
某个功能没人用一定是因为入口太深
这些猜测有时会对,但也经常错得很离谱。
真正难的地方不在于提出一个“看起来像原因”的解释,而在于你有没有办法从真实数据、真实样本和真实行为里,把判断校正回来。
所以这章对我来说,真正重要的不是“垃圾邮件过滤器的历史”,而是一个很普遍的提醒:
直觉可以帮你起步,但不能代替验证。
五、好的判断,不是更会猜,而是更会从样本里学习
第八章里还有一个我特别喜欢的点,就是 Paul Graham 明确承认,统计方法一上来并不是黑客最自然的直觉。
这件事我特别能理解。
因为很多做技术的人,本能上更喜欢“我看懂了问题,我来设计规则”的那种掌控感。它很符合工程师的自我形象,也很有成就感。
但现实世界里,很多系统已经复杂到不是靠几个局部规则就能概括。
垃圾邮件是这样,推荐算法是这样,风控是这样,产品留存是这样,用户行为分析也是这样。
一个系统只要进入真实环境,就会充满噪音、例外、策略对抗和复杂反馈。
这时候更有价值的能力,不一定是你比别人更会拍脑袋猜原因,而是你更愿意承认自己的直觉会错,并且更擅长从样本里学习。
我觉得这点在 AI 时代也很重要。
因为现在工具越来越强,模型给出的解释越来越顺滑,人很容易产生另一种新的错觉:只要这段解释听起来合理,它就大概是对的。
但“听起来像”从来不等于“经过验证”。
所以我现在越来越重视一个习惯:
遇到复杂问题,先尽量找样本,找数据,找行为证据,再做结论。
这不只是工程方法,也是判断力的一部分。
六、品味这件事,不是虚的,它决定你最后做出来的东西到底像不像样
第九章《设计者的品味》应该是我最喜欢的一章之一。
因为它把一个很容易被说空的话题,重新拉回了实践层面。
我们今天一提“品味”,很多人会立刻说这很主观,每个人喜欢的不一样,没必要争。这个说法在日常社交里也许可以止战,但如果你真的开始做东西,就会发现它不够。
因为一旦你自己开始设计界面、写代码、搭产品、组织交互、写文案、做系统,很多好坏其实并不是完全说不出来的。
你会慢慢发现,不同领域对“好”的判断,居然真的有很多相通之处。
Paul Graham 在这一章里列了很多“好设计”的特点,比如:
简单
永不过时
解决主要问题
有启发性
带一点趣味
艰苦得来
看起来容易
对称
模仿自然
反复再设计
能被复制
常常有点奇特
常常是大胆的
如果只把这串列表抄下来,当然很容易变成一组漂亮格言。
但我自己读的时候,最强的感觉不是“这些话很对”,而是:这些标准在软件里真的有非常具体的落点。
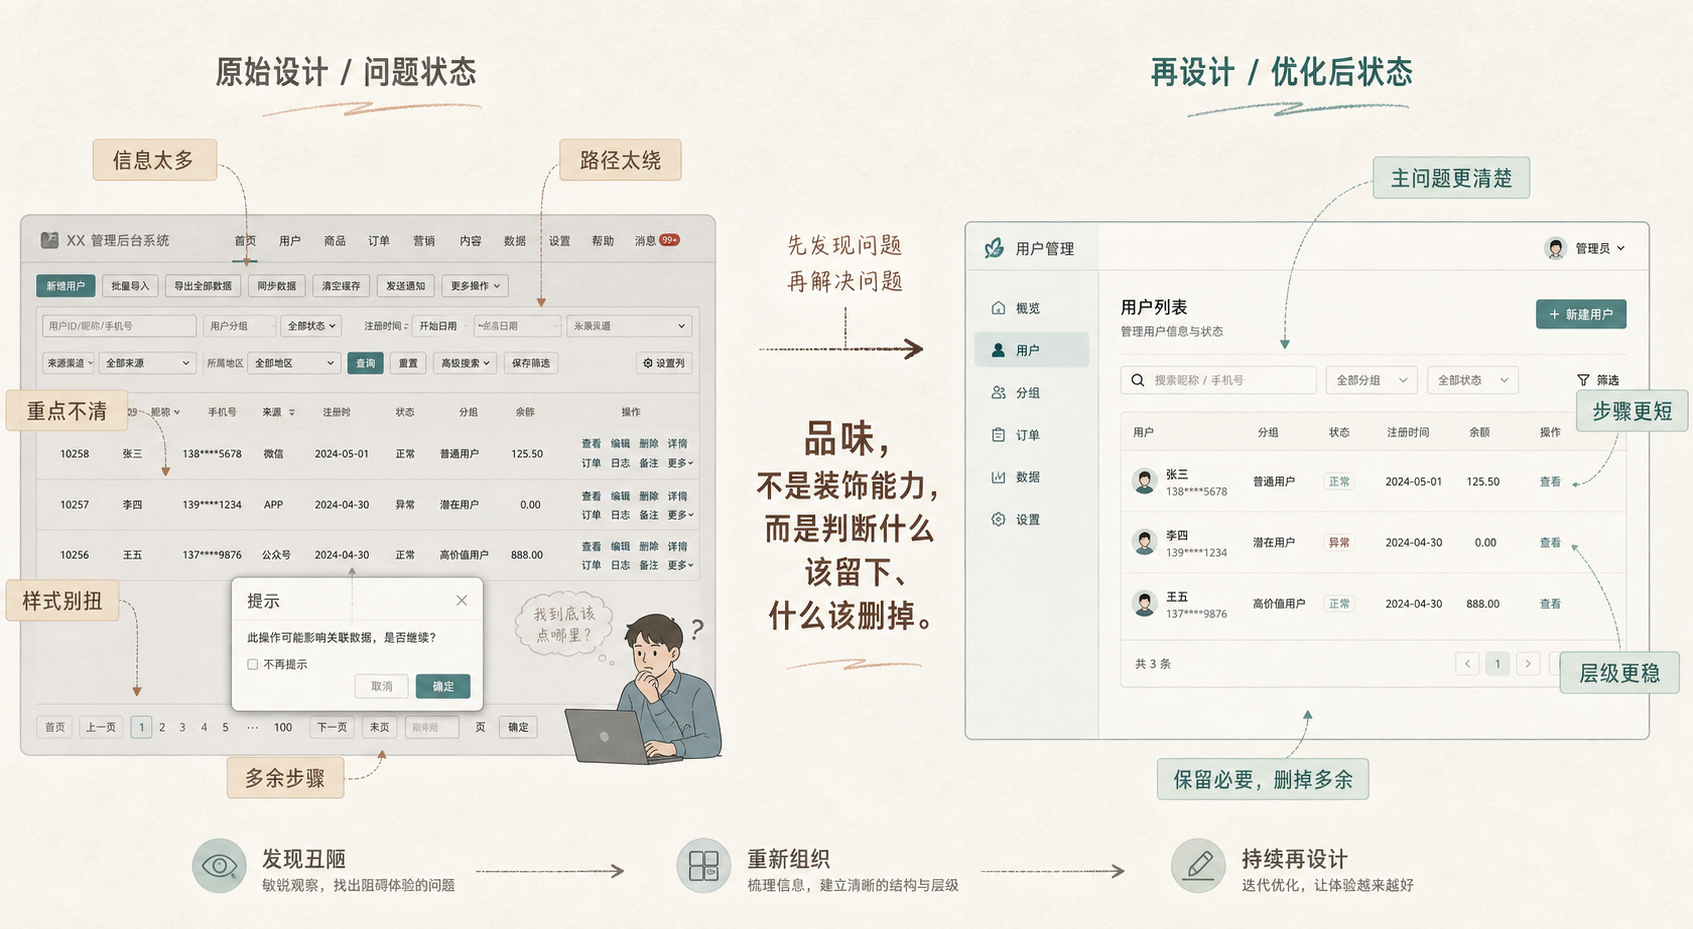
比如“好设计是简单的”,不只是页面干净,而是用户不需要绕路。
“好设计是解决主要问题的”,不只是功能齐全,而是你知道什么是最该先解决的。
“好设计是一种再设计”,也不是说你多画几版稿子,而是你有能力先做原型,再承认它不够好,然后继续改。
这一点我真的越来越有感受。
很多软件看起来功能不少,但一用就觉得别扭,往往不是因为团队不会做,而是因为它们没有足够好的品味去判断什么该留下,什么该删掉,什么才是真正重要的主问题。
七、好品味不是“天生审美”,而是你是否能持续发现丑陋并不忍受它
第九章最后有一段我很喜欢。
Paul Graham 说,他觉得发现丑陋的东西,往往比凭空想象出优美的东西更容易。很多伟大成果的出现,常常来自某个人看到一样东西后,心里想的是:
“这解决得太糟糕了,我能做得更好。”
这句话我很有共鸣。
因为很多时候,真正推动一个开发者去做东西的,不一定是宏大理想,而是你在日常使用里不断被某种低效、笨重、难看、别扭的东西刺到,然后你开始受不了它。
我自己很多时候也是这样。
看到一个流程特别绕、一个页面特别难用、一个需求明明可以更直接却被做得很复杂,心里就会冒出那个念头:这不应该是最好的解法,一定还有更自然的方式。
我觉得这就是品味最实际的起点。
不是高高在上地谈审美,不是把“高级感”挂在嘴上,而是你能不能足够熟悉一个领域,以至于你真的能分辨出:
什么是多余的
什么是别扭的
什么是偷懒的
什么是没有想透的
只有熟到这个程度,你心里才会出现那个很细微但很重要的声音:
“这样解决太糟糕了。”
而很多真正好的东西,也就是从这一瞬间开始的。
八、这三章放在一起,其实是在讲同一个成长方向
如果把第七、八、九章合在一起看,我觉得它们其实刚好构成了一条很完整的成长路径。
第七章在讲,你要理解价值是怎么被创造和放大的。
第八章在讲,你不能只靠直觉,要学会用更聪明的方式修正判断。
第九章在讲,当你真的开始做东西以后,最后决定成品高度的,是你有没有品味。
这三件事其实非常像今天一个开发者从“会写代码”走向“能做出东西”的过程:
先理解什么是真正有价值的东西
再学会怎么判断问题,而不是只凭第一反应
最后形成对好东西的稳定识别能力
我现在越来越觉得,AI 时代真正稀缺的,也会越来越是这三类东西。
因为执行层会越来越便宜,代码生成会越来越容易,信息获取会越来越快。
但哪怕工具再强,也不会自动替你完成这三件事:
它不会替你决定什么值得做
不会替你保证判断一定是对的
也不会替你长出真正的品味
结语:技术会放大人,但先要看你身上有什么值得被放大的东西
重读这三章以后,我最大的感受是,它们其实都没有在神化技术。
Paul Graham 当然相信技术,也相信黑客、创业者、设计者和创造者的力量,但他并没有把技术写成一种自动发生的正义。相反,他一直在提醒:
技术只是一种放大器。
它会放大你的创造力,也会放大你的短视。 它会放大你的判断力,也会放大你的误判。 它会放大你的好品味,也会放大你的粗糙。
所以真正值得焦虑的,也许从来不是“工具会不会太强”,而是:
当工具越来越强的时候,我们自己身上到底有什么是值得被放大的。
对我来说,这三章最后留下来的,不是某个单独的理论,而是一个很实在的提醒:
如果想在这个时代做出点真正值钱的东西,光会写代码不够,光会追工具也不够。
你还得慢慢长出三种能力:
对价值的理解
对判断的修正
对好东西的品味
而这三件事,可能才是一个开发者真正长期的复利。
评论